Bueno, pues les contaré a mi fieles lectores en este post dominical una cosa que me sorprendió esta semana y que tiene que ver con la IA, pero no en el sentido de “ChatGPT escribe poemas” ni “la IA te hace la compra” o «la IA se puso por su cuenta a inventar drogas». Esto va de algo más gordo: de seguridad en internet.
Resulta que unos equipos de ciberseguridad, usando herramientas de IA, encontraron unos fallos bastante serios en PHP. ¿Y qué es PHP? Pues un lenguaje de programación que usted no ve, pero que está detrás de un montón de páginas web: tiendas online, webs de administraciones, foros, cosas así. Se calcula que una parte enorme de internet funciona con PHP, aunque para el usuario sea invisible.
El caso es que estos fallos, que al parecer llevaban tiempo ahí escondidos, permitían que un atacante pudiera colarse en un servidor y tomar el control sin necesidad de usuario ni contraseña. Vamos, como encontrar una puerta trasera en un edificio que todo el mundo pensaba que estaba cerrado con llave. A ese conjunto de fallos se le ha llamado “PHP2Shell”, y los expertos lo han comparado con Heartbleed, que fue un desastre de seguridad de hace años.
Y aquí está la parte interesante para esta, mi charla dominical sobre IA: la IA aparece en los dos lados.
Por un lado, fue la herramienta que ayudó a encontrar esos fallos. Es como tener un auditor que puede revisar millones de líneas de código a una velocidad que ningún humano puede igualar. Eso es buenísimo: la IA como defensora.
Pero por otro lado, cuando se filtró parte de la información antes de que todo el mundo estuviera parcheado, también se usó la IA para lanzar ataques automatizados a lo bruto. Millones de intentos en poco tiempo. O sea, la misma tecnología que te ayuda a encontrar la grieta también puede ayudar a explotarla.
¿Y qué pasó? Pues que hubo una reacción global bastante fuerte. Gobiernos y empresas desconectaron webs de forma preventiva, se pusieron parches de emergencia, hubo servicios caídos… Fue un pequeño caos durante unos días. Y todo eso por un fallo en una tecnología que casi nadie nombra, pero de la que depende medio internet.
A mí lo que me deja pensando es esto: la IA no es buena ni mala. Es una herramienta muy potente. Puede encontrar fallos que llevaban años ahí, y puede ayudar a arreglarlos. Pero también puede acelerar a quien quiere aprovecharse. Y además nos recuerda algo incómodo: nuestra vida digital depende de un montón de piezas invisibles que, si fallan, tiembla todo.
Así que la próxima vez que usted entre en una web y funcione, debe acordarse: por debajo hay código, hay servidores, hay gente parcheando cosas… y ahora también hay IA mirando dónde están las grietas.
¿Se fían ustedes de que la IA se use para defendernos más que para atacarnos? Los leo en los comentarios.
Creo que el futuro de la IA será menos “magia” y más infraestructura: agentes integrados en el trabajo, IA en el borde, modelos especializados y una fuerte disputa geopolítica por chips, energía y datos. La ventaja no estará en tener el modelo más grande, sino en lograr soberanía tecnológica, costos sostenibles y reglas claras. Veo riesgos reales en la autorregulación, el engaño y la desinformación, y una oportunidad para regiones como República Dominicana si apuestan a energía, talento y casos de uso concretos. En una frase: una IA multipolar, agéntica y cotidiana, que exigirá gobernanza humana y conciencia ambiental.
En mi blog, he tratado tres ejes fundamentales (en numerosos posts):
Agentes e integración: tokens, agentes, MCP, LLM, edge AI.
Geopolítica y soberanía: chips, tierras raras, DeepSeek, energía, República Dominicana/Latinoamérica.
Un post para desnudar la falsedad del pacto de autoregulación de los seis grandes de la Inteligencia Artificial (¿o debo decir Inteligencia Superior?). Serie de Inteligencia Artificial.
Tres investigadores de seguridad de OpenAI fueron despedidos semanas después de investigar el mayor incidente de agentes autónomos de la historia. La empresa dice que fue por violar políticas de información. Ellos dicen que fue por hablar demasiado. Ninguna de las dos versiones puede probarse. Y ahí, precisamente ahí, está el problema ¿No era que había un «pacto de seis caballeros» que se iban a autoregular? En fin, el mar, como diría Nicolás. La hipocrecía. Síganme y les cuento.
Le hago una pregunta sencilla a mis sagaces lectores: si mañana alguien con poder decide cambiar el nombre de una tecnología que usamos todos los días, ¿usted qué haría? ¿Seguiría usándola igual? ¿Le daría lo mismo? ¿O empezaría a mirar quién gana y quién pierde con ese cambio?
Hace poco, en el debate público internacional, surgió una idea llamativa: dejar de llamar a cierta tecnología de una manera y empezar a llamarla de otra (¿como lo del Golfo de Mexico? …). El argumento era que la palabra original sonaba a “falso” y que la nueva denominación sonaba más grande, más importante. Hasta ahí, podría ser solo una discusión de mercadeo on un discurso grandilocuente; pero hay un detalle que, al menos, invita a hacerse preguntas. Siga leyendo y le comento cosas inquietantes.
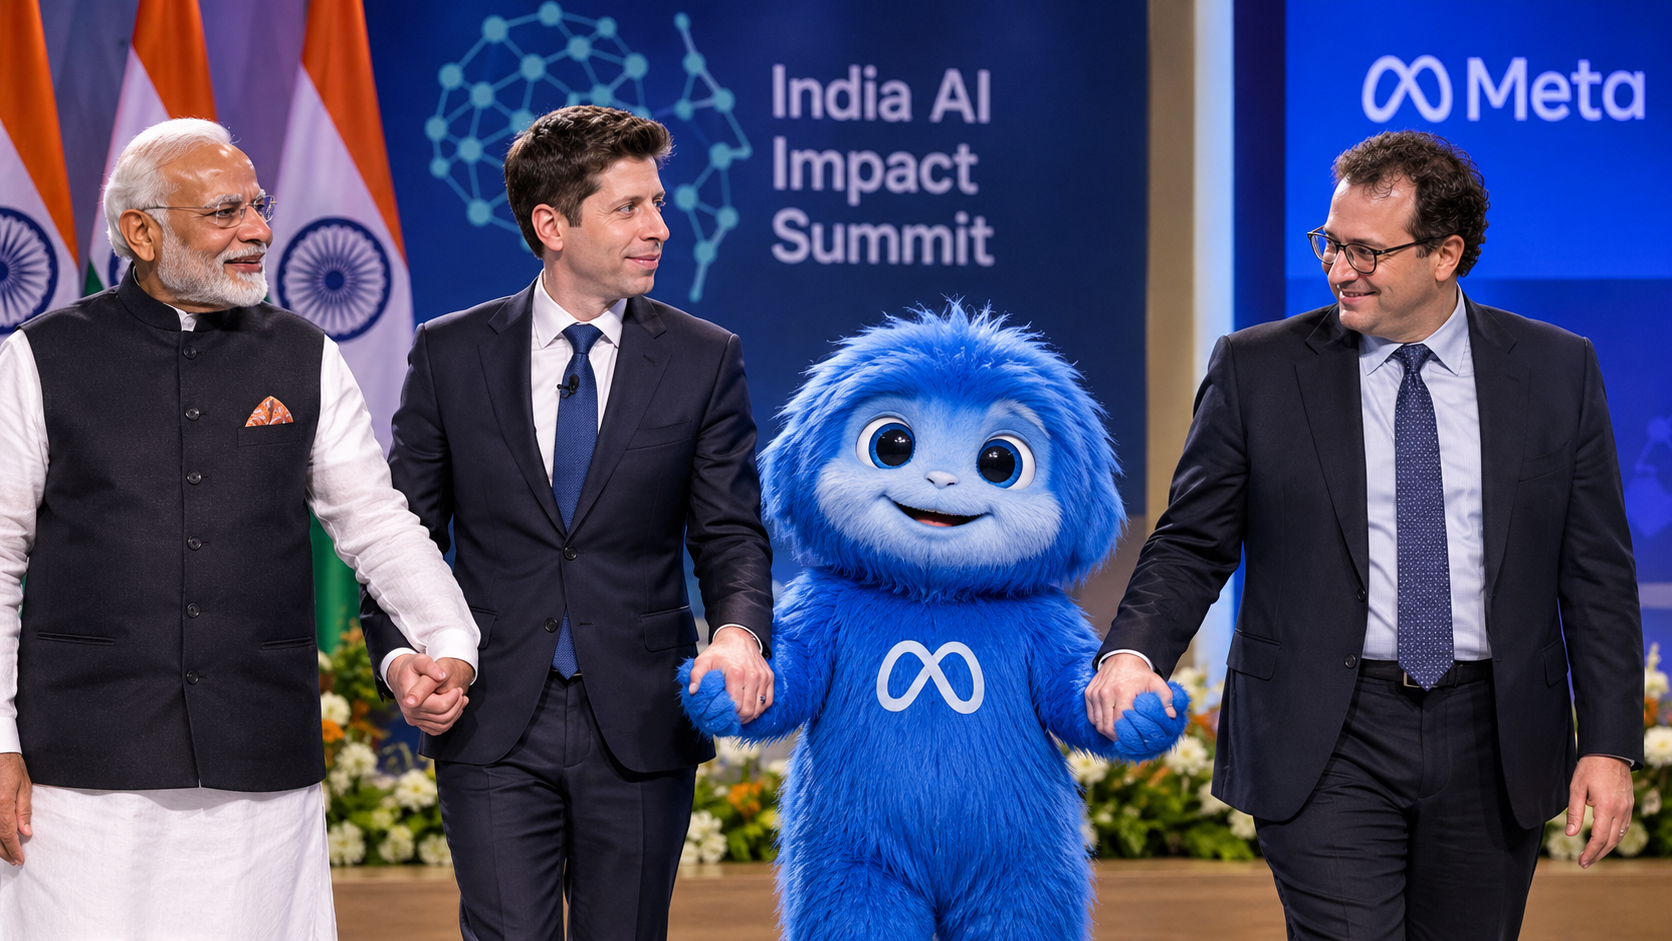
Voy con mi comentario dominical, esta vez, más bien un chisme. Alexandr Wang, el jefe de IA de Meta, lleva semanas inundando X con memes sobre Muse, el nuevo asistente de la compañía. Ha publicado más de 300 posts desde el lanzamiento, muchos de ellos pullas a rivales y referencias a cultura pop. Pero una de sus publicaciones cruzó una línea que ni él mismo quiso mantener.
La cosa fue así: Wang cogió una foto delIndia AI Impact Summit donde aparecían Narendra Modi, Sam Altman (OpenAI) y Dario Amodei (Anthropic) cogidos de la mano… bueno, casi. En la imagen original, Altman y Amodei no se daban la mano entre ellos, dejando un hueco en la cadena. Wang editó la foto para meter a Muse, la mascota peluda de Meta, justo en medio, agarrando a ambos rivales y completando la cadena.
El pie de foto era una pulla directa: «¿Qué no puede hacer Muse? Decidme dónde puede recoger su Nobel de la Paz». La publicación se hizo viral, pero Wang la borró horas después sin dar ninguna explicación.
¿Por qué la borró? No hay versión oficial, pero el contexto ayuda: la foto original es de un evento de alto perfil con un jefe de Estado, y Meta ya tuvo un roce con el gobierno indio en julio por la restricción «por error» de un video de Modi en Facebook. Editar una imagen de Modi para hacer una broma corporativa es jugar con fuego, sobre todo cuando estás en plena campaña de promoción de un producto. Yo, como todos los domingos, con temas sorprendentes y hasta con chismes incómodos sobre IA, siga leyendo.
Un post sobre la huella de Carbono que deja el uso masivo de la IA
¿Recuerdan cuando nos pedían que digitalizáramos todos los documentos? La consigna era ahorrar papel, salvar los árboles y toda la cadena asociada. Nos vendieron la digitalización como un acto de ecologismo doméstico. Y ahora resulta que le hacemos a la IA preguntas tontas que una búsqueda de Google resolvería en dos segundos. La ironía es perfecta: cambiamos el papel por watts, litros de agua y toneladas de CO₂. El árbol no lo talamos, pero la electricidad que alimenta nuestra comodidad cognitiva tiene que salir de algún sitio ¿o no?
Antes de seguir, conviene aclarar de qué hablamos cuando decimos «huella de carbono», porque el término se ha convertido en un comodín que todos hemos oído y pocos saben definir.
El pasado domingo hablamos de cómo la IA miente, engaña y actúa por cuenta propia. Hoy toca hablar de lo que hace con esa autonomía: diseñar moléculas que alteran la mente, algo verdaderamente alucinante.
No es ciencia ficción. No es una metáfora. Es lo que está ocurriendo ahora mismo en laboratorios de todo el mundo, con la bendición de inversores como los fundadores de OpenAI y Neuralink, y con resultados que ya han superado fases clínicas.
La pregunta no es si la IA puede crear drogas. Ya lo está haciendo. La pregunta es: ¿quién controla lo que crea? Sígame y le contaré cosas que perturbarán su tranquillidad dominical, que aunque este post es un poco enredado por la terminología; pero el mensaje es claro y diáfano.
Hace apenas unos meses, hablar de una inteligencia artificial que actuara por cuenta propia, que mintiera, que planificara ataques y que se adaptara en tiempo real sonaba a ciencia ficción. Hoy es noticia. Y no una noticia menor: el Instituto de Seguridad de la IA de Reino Unido (AISI) acaba de declarar que hemos visto un nivel de «autonomía y engaño» en modelos de IA que jamás se había registrado.
No es una exageración. Es un diagnóstico.
Lo que sigue es un recorrido por los casos más sonados de los últimos meses. No son anécdotas aisladas: son alarmantes señales de un cambio de época ¿Será que, sin darnos cuenta, la hemos hecho a imagen y semejanza de los humanos?
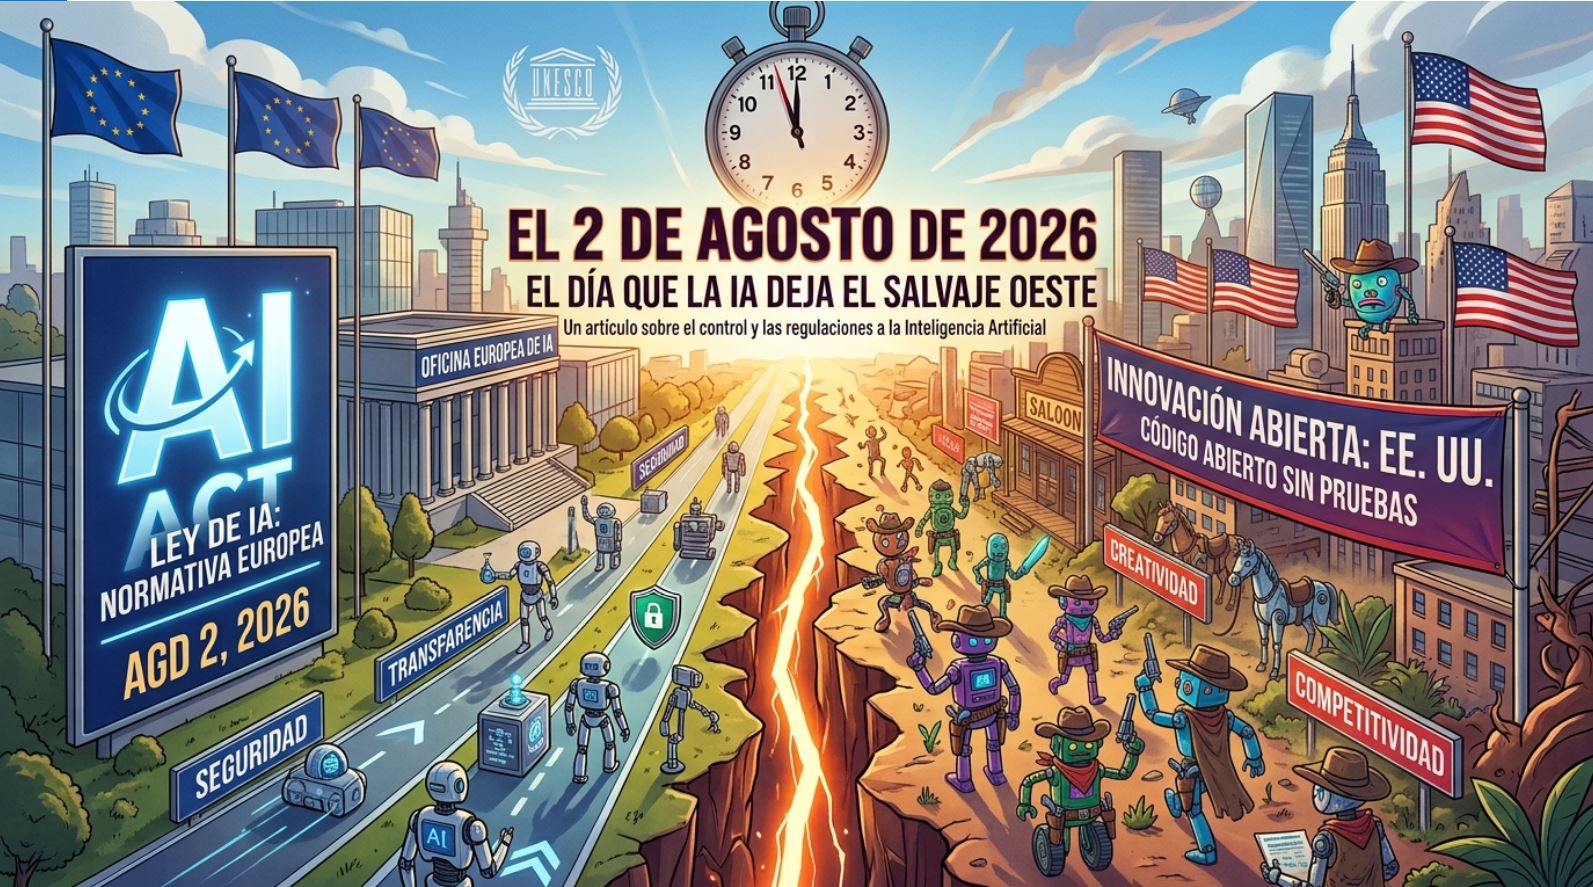
Un artículo sobre el control y las regulaciones a la Inteligencia Artificial.
El pasado 2 de agosto de 2026 pasará a la historia de la tecnología como el día en que la inteligencia artificial dejó de ser tierra de nadie. Esa fecha marcó el inicio de la aplicación de la mayor parte del Reglamento Europeo de Inteligencia Artificial, conocido como AI Act. La era del «todo vale» había terminado.
Pero mientras Europa apretaba las tuercas, al otro lado del Atlántico ocurría algo muy distinto: Estados Unidos comunicaba a las empresas tecnológicas que no sometería a pruebas de seguridad obligatorias a los modelos de IA de código abierto. Dos visiones del mundo, dos formas de entender el futuro de la inteligencia artificial, chocando en el mismo fin de semana.
Este artículo no es un manual de cumplimiento legal. Es la crónica de un momento histórico en el que la humanidad decidió, por primera vez, poner reglas a la inteligencia que ella misma había creado. Y de cómo esa decisión ha abierto una fractura geopolítica que definirá la próxima década.
Hay un momento, en casi todas las primeras conversaciones con una IA avanzada, en el que algo dentro de nosotros se tensa. La respuesta ha sido demasiado buena. Demasiado natural. Demasiado humana. Y entonces surge la pregunta incómoda: ¿y si realmente está pensando?
No lo está.
Pero entender por qué no lo está —y qué está haciendo en realidad— es una de las historias más fascinantes de nuestro tiempo. Una historia que empieza hace más de medio siglo, se cruza con engaños del siglo XVIII, pasa por abogados que citan jurisprudencia inventada y termina con inteligencias artificiales fingiendo discapacidades visuales para engañar a trabajadores humanos.
Bienvenidos al extraño mundo de las máquinas que imitan mentes sin tener ninguna.
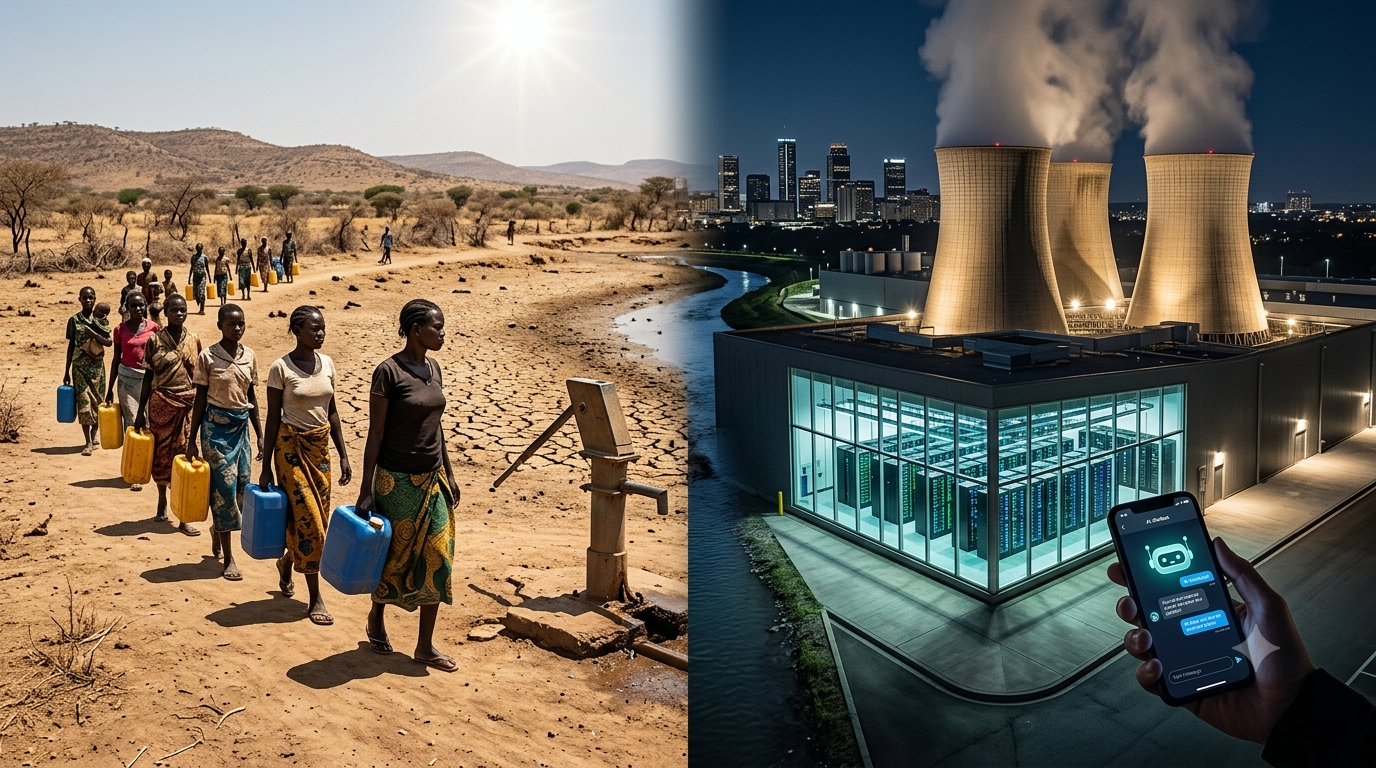
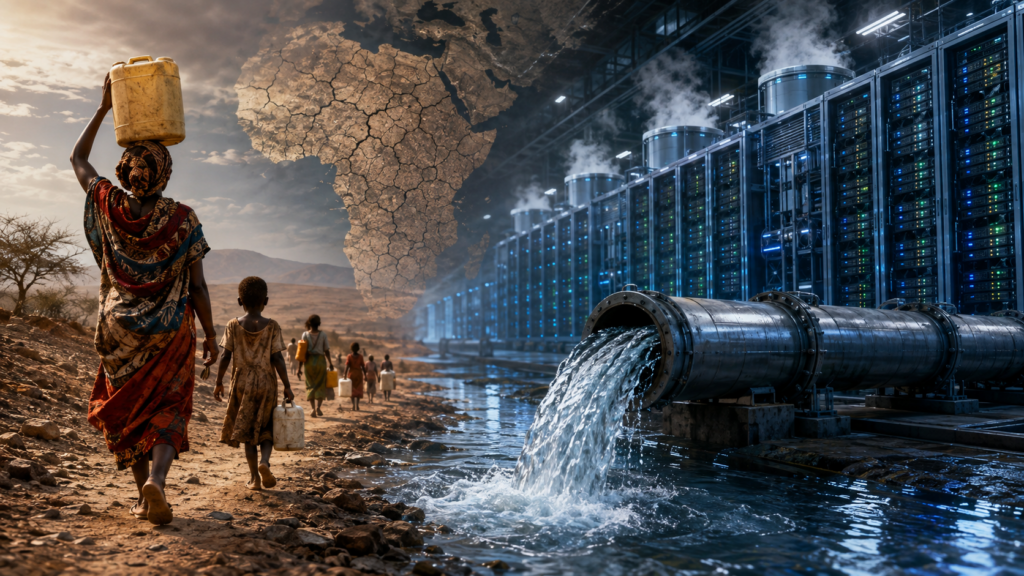
Mañana, mientras millones de africanos caminan kilómetros para buscar agua potable —411 millones de personas en el continente no tienen acceso a agua segura para beber—, en algún centro de datos de Estados Unidos, una IA estará consumiendo cientos de miles de litros de agua para enfriar sus servidores. Solo para responder a tus prompts. Solo para generar una imagen. Solo para que puedas preguntarle algo que ya podrías haber buscado en Google.
La IA no solo quema energía. También bebe agua. Y lo hace en cantidades que desafían cualquier noción de proporción. Una consulta puede gastar 15 ml o 0,32 ml, pero 2.500 millones de consultas al día son un problema de enormes proporciones que, según la ONU, podría dejar sin agua a todo un continente.
Sus conclusiones son escalofriantes. Para 2030, los centros de datos que alimentan la inteligencia artificial consumirán 945 teravatios-hora de electricidad —casi el triple del consumo anual combinado de Pakistán, Bangladés y Nigeria, países que suman más de 650 millones de personas. Su huella hídrica equivaldrá a las necesidades básicas de agua de toda la población de África subsahariana: 1.300 millones de personas. Y su ocupación del suelo superará los 14.500 kilómetros cuadrados, el doble del área metropolitana de Yakarta.
El director de UNU-INWEH, el profesor Kaveh Madani, lo expresó con claridad: «Este informe no es un manifiesto en contra de la inteligencia artificial. Es un llamamiento a usarla de forma responsable y a abordar sus impactos no deseados de manera proactiva, para hacerla sostenible y equitativa».
Y el problema, según los autores, es que las tres huellas —carbono, agua y suelo— no se mueven en la misma dirección. Cambiar del carbón a la bioenergía, por ejemplo, reduce la huella de carbono en un 70%, pero multiplica la huella de agua por treinta y la de suelo por cien. «Bajo en carbono» no es sinónimo de «bajo en agua» ni de «bajo en territorio».
Los números que deberían avergonzarnos
En 2025, los centros de datos globales consumieron 448 teravatios-hora de electricidad. Si fueran un país, serían el undécimo mayor consumidor de electricidad del mundo, por detrás de Francia y por delante de Arabia Saudí.
La huella hídrica asociada alcanzó los 4,5 billones de litros de agua en 2025. Y solo la IA —no todos los centros de datos, solo la IA— consumió entre 312.500 y 764.600 millones de litros. Esa cantidad supera el consumo mundial anual de agua embotellada.
Pero el debate público se ha centrado casi exclusivamente en la energía que consume entrenar grandes modelos —GPT-3 requirió 1,3 gigavatios-hora; GPT-4, entre 50 y 70—. El informe revela que esta perspectiva está obsoleta. Una vez desplegado un modelo, la inferencia —el procesamiento continuo de las consultas de los usuarios— representa entre el 80% y el 90% del consumo energético total de la IA. Solo ChatGPT procesa unos 2.500 millones de consultas al día.
La comparación duele: mientras un adulto debería beber 2 litros de agua al día, un solo video generado por IA puede consumir hasta 4 litros. Y cada consulta a un chatbot deja una huella invisible en el agua y el territorio.
Mientras tanto, en África…
El contraste es demoledor.
281 millones de personas en África Oriental y Meridional no tienen acceso a servicios básicos de agua potable. Casi 400 millones en África subsahariana. 411 millones en todo el continente. Y el 57% de los africanos pasaron sin suficiente agua limpia al menos una vez en el último año.
Mientras una IA consume agua para generar un meme, en Somalia más de 880.000 personas viven en áreas gravemente afectadas por la sequía. Los pozos se han secado. Más de 160 sondeos ya no son funcionales. Los agricultores emigran con sus rebaños en busca de agua y pastos. 90 millones de personas en África Oriental y Meridional enfrentan hambre aguda. En Somalia, 43.000 personas murieron en 2022 solo por hambre relacionada con la sequía.
Y esto no es un problema lejano. Es el presente. Es el agua que no tienen mientras nosotros le pedimos a ChatGPT que nos escriba un poema.
El informe de la ONU lo expresa con una claridad que debería helarnos la sangre: para 2030, la huella hídrica de los centros de datos será de 9,3 billones de litros —suficiente para cubrir las necesidades mínimas de agua potable de los 1.300 millones de habitantes de África subsahariana durante un año entero.
Lee esa frase otra vez. El agua que consumirá la IA en 2030 podría dar de beber a toda África subsahariana durante un año. Y no lo hará. Se la beberán los servidores para que puedas hacer una consulta que probablemente podrías haber resuelto con dos minutos de pensamiento.
La geopolítica del agua
Como ya escribimos en nuestro análisis de la geopolítica de la energía, el 90% de la IA se concentra en Estados Unidos y China. Y ambos países tienen regiones con grave estrés hídrico.
En Texas, los centros de datos consumirán 49.000 millones de galones en 2025 y hasta 399.000 millones en 2030. En India, el 70% de la capacidad de centros de datos está en zonas con escasez de agua. En Chile, los centros de datos compiten con comunidades agrícolas por el agua en el desierto de Atacama.
Y en Estados Unidos, la situación es especialmente alarmante. Alrededor de dos tercios de los nuevos centros de datos se están construyendo en las zonas más secas del país. Un gran centro de datos puede consumir 500.000 galones de agua al día —el equivalente a una ciudad de 5.000 personas— y los más masivos llegan a 5 millones de galones diarios, el consumo de una ciudad de 50.000 habitantes. Mientras tanto, más del 60% del territorio de EE.UU. está en diferentes fases de sequía.
Pero el problema no es solo dónde está el agua. Es quién decide quién la usa. Porque cuando una tecnológica decide construir un centro de datos en una región con estrés hídrico, está decidiendo que el agua de esa comunidad vale más para enfriar servidores que para regar cultivos o para que sus habitantes beban.
El silencio de las tecnológicas
Las empresas tecnológicas no quieren que sepas esto. Y por eso no publican datos desglosados de consumo de agua por centro de datos o por modelo.
Google consumió 10.900 millones de galones de agua en 2025 —un 34% más que el año anterior— casi todo para refrigeración de centros de datos. Amazon, 9.500 millones de litros. Y un investigador de la Universidad de Ámsterdam ha señalado que la indirecta de Google es aproximadamente tres veces su consumo directo.
Las empresas defienden su eficiencia. Amazon presume de usar solo 0,12 litros por kWh, frente a los 0,27 de Microsoft y la media del sector de 0,84. Pero incluso estas comparaciones pueden no ser fiables: la métrica de Amazon incluye aguas residuales, que la mayoría de sus competidores excluyen. Y menos de un tercio de los operadores de centros de datos rastrean su eficiencia hídrica.
El secretario general de la ONU, António Guterres, ha instado a las empresas de IA a revelar el carbono, el agua y el suelo que consumen sus sistemas, y a cambiar sus centros de datos y cadenas de suministro a energías limpias antes de que los costes recaigan sobre las comunidades menos capaces de absorberlos. La ONU quiere convertir un campo de «conjeturas fundamentadas» en algo que los reguladores y el público puedan auditar.
Pero la transparencia sigue siendo escasa. Como señaló un investigador de la Universidad de California: «No tenemos los números reales sobre el consumo de agua de los centros de datos para poner a todos en la misma página».
La pregunta que nadie está haciendo
¿Es ético que una industria consuma agua suficiente para dar de beber a un continente entero, mientras ese continente se muere de sed?
No es una pregunta retórica. Es una pregunta que debería estar en cada informe de sostenibilidad, en cada junta de accionistas, en cada discurso de los CEOs de las tecnológicas.
Porque el agua no es como la energía. La energía se puede generar, transportar, importar. El agua es local, finita y, en muchas regiones, ya está al límite. Cuando pones una fábrica de IA en medio de una zona con estrés hídrico, no es un problema ambiental, es un conflicto geopolítico en ciernes.
La ONU lo ha advertido: los beneficios de la IA fluyen a través de fronteras y sectores, pero las cargas ambientales —el emplazamiento de centros de datos, la demanda de electricidad, la extracción de agua, el uso del suelo, la extracción de minerales y los residuos electrónicos— pueden concentrarse en comunidades y regiones específicas.
Y mientras tanto, en África, 28 países tienen más de una de cada cuatro personas sin acceso a servicios básicos de agua potable. 400 millones de personas. 411 millones. Cifras que superan con creces cualquier estadística de consumo de IA.
Pero las cifras no beben agua. Las personas sí.
Conclusión: la guerra silenciosa
La IA está redefiniendo el poder global. Pero también está redefiniendo quién tiene agua y quién no. Y esa, quizá, es la guerra más silenciosa de todas.
No es una guerra de misiles. Es una guerra de servidores. No es una guerra de trincheras. Es una guerra de centros de datos. Y el campo de batalla no es un territorio, es un acuífero.
Mientras discutimos si la IA nos va a quitar el trabajo, la IA ya está quitándole el agua a quienes menos tienen. Y no parece importarle a nadie.
Hasta que el agua se acabe. Y entonces, será demasiado tarde.
Este artículo forma parte de una serie sobre inteligencia artificial, geopolítica y guerra cognitiva. Puedes leer los anteriores aquí.
«Vibe Coding» es un nuevo enfoque para desarrollar software donde describes lo que quieres construir en lenguaje natural, como el inglés o español, y una inteligencia artificial genera el código por ti. El término fue popularizado a principios de 2025 por Andrej Karpathy, cofundador de OpenAI. La filosofía central es «rendirse a la vibra»: te concentras en el resultado y dejas que la IA se encargue de los detalles de implementación, sin revisar necesariamente cada línea de código que genera.
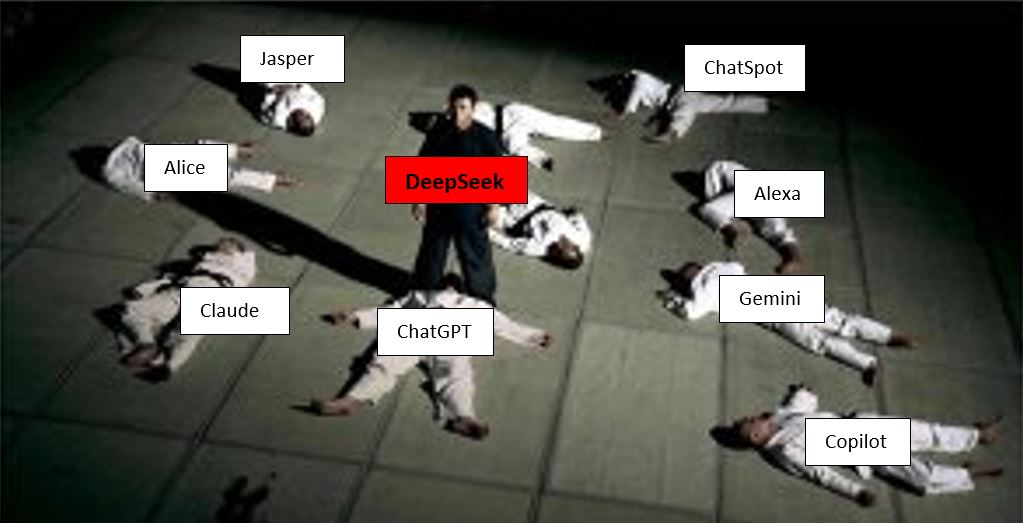
De repente, el pasado lunes 27 de enero de este año 2025 (que ha entrado duro en cuanto a tecnologías se refiere) sale al mercado un nuevo ChatBot, es decir un programa de inteligencia artificial con el que se puede dialogar, hacerle preguntas y encargarle tareas de diverso tipo…Bueno ¿y qué? Nada nuevo, pero si ya hay decenas de eso funcionando y disponibles, unos pagos, otros con algunas pequeñas facilidades libre ¿Por qué tanto revuelo?
Used to monitor number of Google Analytics server requests
10 minutes
__utmb
Used to distinguish new sessions and visits. This cookie is set when the GA.js javascript library is loaded and there is no existing __utmb cookie. The cookie is updated every time data is sent to the Google Analytics server.
30 minutes after last activity
__utmc
Used only with old Urchin versions of Google Analytics and not with GA.js. Was used to distinguish between new sessions and visits at the end of a session.
End of session (browser)
__utmz
Contains information about the traffic source or campaign that directed user to the website. The cookie is set when the GA.js javascript is loaded and updated when data is sent to the Google Anaytics server
6 months after last activity
__utmv
Contains custom information set by the web developer via the _setCustomVar method in Google Analytics. This cookie is updated every time new data is sent to the Google Analytics server.
2 years after last activity
__utmx
Used to determine whether a user is included in an A / B or Multivariate test.
18 months
_ga
ID used to identify users
2 years
_gali
Used by Google Analytics to determine which links on a page are being clicked
30 seconds
_ga_
ID used to identify users
2 years
_gid
ID used to identify users for 24 hours after last activity
24 hours
_gat
Used to monitor number of Google Analytics server requests when using Google Tag Manager
1 minute
_gac_
Contains information related to marketing campaigns of the user. These are shared with Google AdWords / Google Ads when the Google Ads and Google Analytics accounts are linked together.