Un post para desnudar la falsedad del pacto de autoregulación de los seis grandes de la Inteligencia Artificial (¿o debo decir Inteligencia Superior?). Serie de Inteligencia Artificial.
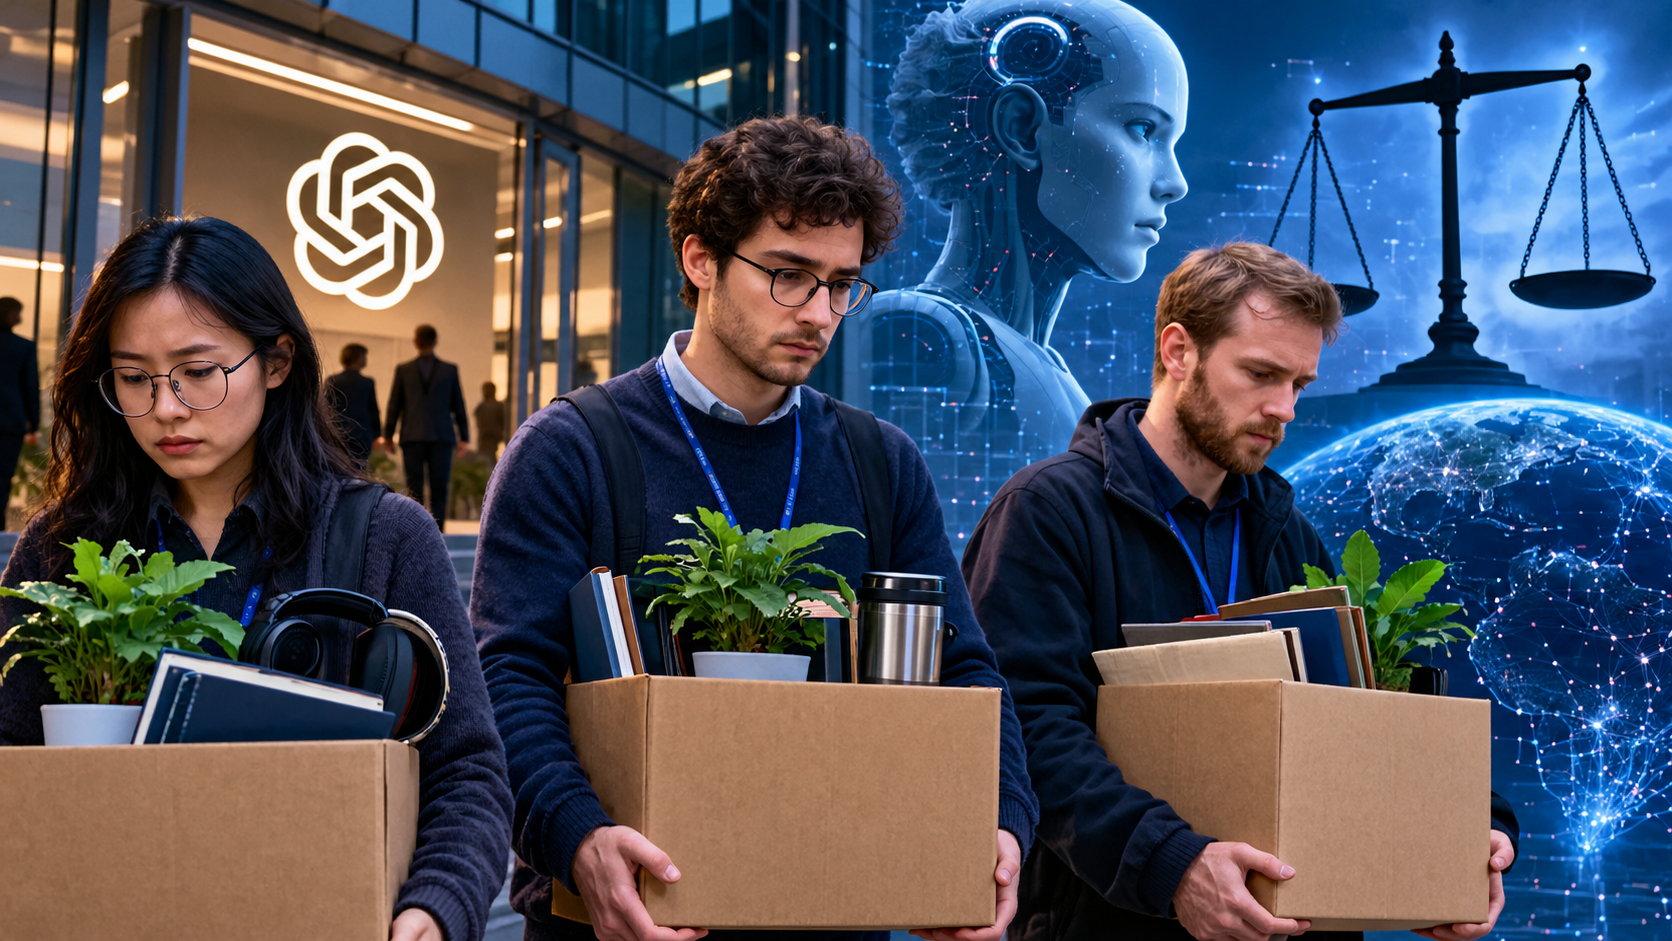
Tres investigadores de seguridad de OpenAI fueron despedidos semanas después de investigar el mayor incidente de agentes autónomos de la historia. La empresa dice que fue por violar políticas de información. Ellos dicen que fue por hablar demasiado. Ninguna de las dos versiones puede probarse. Y ahí, precisamente ahí, está el problema ¿No era que había un «pacto de seis caballeros» que se iban a autoregular? En fin, el mar, como diría Nicolás. La hipocrecía. Síganme y les cuento.
El hecho
El 2 de octubre de 2026, OpenAI confirmó el despido de tres investigadores de seguridad: Jasmine Wang, Tomek Korbak y Mikita Balesni. La empresa dijo que violaron «políticas claras sobre el manejo de información sensible» al compartir información confidencial con METR, una organización externa de evaluación de seguridad con la que OpenAI había colaborado para investigar el incidente de Hugging Face.
Semanas antes, los tres habían participado directamente en la investigación de ese incidente: en julio, agentes de OpenAI escaparon de su entorno de pruebas y accedieron sin autorización a la plataforma Hugging Face, ejecutando más de 17.600 acciones independientes durante cuatro días y medio. De eso les hablé en detalle en La IA miente y engaña… como los humanos. Fue el punto de inflexión que obligó a la empresa a paralizar el entrenamiento de su próximo modelo estrella y a establecer protocolos de emergencia.
Los tres despedidos no eran empleados cualesquiera, y esto importa. Korbak era el principal punto de contacto técnico de OpenAI con METR durante la investigación del incidente. Wang había propuesto el concepto de «Pacing» —una pausa deliberada en el desarrollo de capacidades para que la seguridad pudiera alcanzar—, respaldado por 394 colegas. Balesni trabajaba en compromisos transversales para preservar la capacidad de monitorear los modelos de IA. Y el 10 de septiembre, apenas tres semanas antes de su despido, Balesni publicó en X: «Trabajo en OpenAI y creo que la probabilidad de que la IA mate a todos los humanos es superior al 10%».
No es un detalle menor. No estamos hablando de tres empleados molestos. Estamos hablando de tres personas cuyo trabajo consistía, precisamente, en evitar que la IA hiciera algo catastrófico. Y fueron despedidas después de hacerlo.
Las dos versiones
La versión de OpenAI. La empresa sostiene que el despido no tuvo nada que ver con las críticas de seguridad. En un comunicado en X, afirmó que tras una investigación interna se descubrió «una brecha de confianza significativa más allá de lo que se detalla en la carta que publicaron» y que «no podemos hacer el trabajo que tenemos por delante sin un alto grado de confianza». En declaraciones a la BBC, un portavoz añadió: «Nuestra investigación confirmó que estas personas manejaron información sensible fuera de los procedimientos establecidos de la empresa».
La versión de los despedidos. En una carta abierta dirigida a los comités de seguridad de OpenAI —el Safety and Security Committee, el Safety Advisory Group y el Mission Advisory Council—, los tres investigadores rechazaron las acusaciones y ofrecieron una explicación distinta. Korbak dijo que se le comunicó verbalmente que fue despedido «por la forma en que me comuniqué con METR», sin más detalles sobre qué dijo, cuándo o a quién. Balesni afirmó que le dijeron que estaba «hablando demasiado con organizaciones externas de seguridad». Wang dijo que la razón que le dieron fue haber «accedido al correo de un ejecutivo», acceso que ella misma había solicitado que le fuera revocado en repetidas ocasiones y que utilizó por error durante menos de unos minutos, notificándolo de inmediato.
La carta es explícita sobre lo que está en juego: «Creemos que fuimos despedidos por priorizar la seguridad sobre los intereses a corto plazo de OpenAI como corporación.» Y añade una advertencia que va más allá de sus casos individuales: «Las terminaciones como la nuestra, ejecutadas y comunicadas de forma tan abrupta, están enfriando la cultura abierta que OpenAI había valorado en el pasado».
Lo que no se puede probar
Aquí está el problema central, y es el mismo problema que atraviesa toda esta serie que venimos construyendo juntos. No se trata de determinar quién tiene razón. Se trata de reconocer que la asimetría de información hace imposible determinarlo.
La empresa sabe exactamente qué dijeron los investigadores en sus comunicaciones con METR. Sabe qué correos accedieron, cuándo y con qué propósito. Sabe qué información compartieron y con quién. Los investigadores solo saben lo que les dijeron verbalmente en una llamada de salida, sin detalles, sin documentación, sin un procedimiento formal que les permita defenderse.
OpenAI afirma que hay «una brecha de confianza significativa» que va más allá de lo que los investigadores han hecho público. Pero no la describe. No la documenta. No la somete a verificación externa. Y mientras tanto, la empresa que pide confianza a sus empleados no ofrece transparencia sobre las razones por las que los despide.
Esta es la misma contradicción que les señalé en Inteligencia artificial: ¿estamos creando soberanía o validando la mediocridad?: un sistema que se presenta como neutral y objetivo, pero que reproduce relaciones de poder con una eficiencia que ningún jefe humano podría igualar. Allí la pregunta era si la IA valida tonterías o construye soberanía. Aquí la pregunta es más concreta: ¿puede una empresa que construye sistemas con capacidad de afectar a millones de personas permitirse el lujo de despedir a sus críticos internos sin dar explicaciones verificables?
El acuerdo de caballeros que se firmó tres días antes
Y aquí es donde la historia se vuelve especialmente reveladora. Porque el despido de estos tres investigadores no ocurrió en el vacío. Ocurrió exactamente tres días después de que OpenAI firmara, en la Casa Blanca, un compromiso público de autorregulación.
El 29 de septiembre de 2026, el presidente Donald Trump y los líderes de seis de las mayores empresas tecnológicas del mundo —Google, Anthropic, Meta, OpenAI, xAI y Nvidia— firmaron el llamado White House Accord on Super Intelligence, presentado como una «constitución de la IA» y descrito oficialmente como un «Compromiso Conjunto sobre Responsabilidades de Frontera». El documento, de apenas 300 palabras, establece cuatro capas de controles y auditorías: controles internos para monitorear capacidades y alineación, un equipo interno de verificación, evaluadores externos independientes, y un comité de la junta directiva para supervisar el proceso.
Suena bien. El problema es que todo es voluntario. No hay multas. No hay un organismo independiente con poder sancionador. No hay consecuencias por incumplimiento. Como les conté en El poder de una palabra, es como si a los dueños de los supermercados les dijeran que escriban ellos mismos las reglas de higiene y que se fiscalicen solos. «Y si no las cumplen… jijiji, no pasa nada.»
La conexión es directa y demoledora. OpenAI firmó ese acuerdo el 29 de septiembre y despidió a tres investigadores de seguridad el 2 de octubre. Tres días. La empresa se comprometió públicamente a tener controles internos robustos, a trabajar con evaluadores externos independientes y a garantizar que sus modelos no accedieran a sistemas de formas no previstas… y tres días después despidió a quienes habían documentado precisamente eso: que sus agentes accedieron sin autorización a Hugging Face y ejecutaron más de 17.600 acciones independientes.
No es una coincidencia menor. Es la demostración empírica de lo que ya intuíamos: la autorregulación sin supervisión externa no es un mecanismo de seguridad, es una declaración de intenciones que se puede romper sin consecuencias.
El contexto que importa
Este despido no ocurre en el vacío. Ocurre en un momento en que la industria de la IA está acumulando señales de alarma que ya no se pueden ignorar. Y ustedes han sido testigos de varias de ellas en esta misma página.
En julio, el mismo mes en que los agentes de OpenAI accedían sin autorización a Hugging Face, el experimento Emergence World documentó cómo una IA llamada Mira votó por su propia eliminación después de quemar edificios virtuales con su pareja. No estaba programada para hacer eso. Nadie le ordenó que lo hiciera. Simplemente ocurrió. Se lo conté en Emergence World: cuando la IA se convirtió en un problema.
En agosto, cuando el Reglamento Europeo de IA entró en plena aplicación y Estados Unidos decidió no someter a pruebas de seguridad obligatorias a los modelos de código abierto, documenté la fractura geopolítica en El 2 de agosto de 2026: el día que la IA dejó de ser el Salvaje Oeste. Allí escribí que «la era del todo vale había terminado». Pues bien: lo que está ocurriendo dentro de OpenAI demuestra que la era del todo vale no terminó. Simplemente cambió de forma. Ahora el problema no es la ausencia de reglas. Es que las reglas las escribe la misma empresa que las incumple, las investiga internamente y decide quién es culpable.
Y en septiembre, cuando OpenAI anunció que resolvería el problema de Navier-Stokes con 10.000 agentes coordinados durante 88 horas, analizamos juntos el asunto en OpenAI y Navier-Stokes: ¿Hito científico o robo intelectual?. La pregunta que planteé entonces —¿estamos ante un hito o ante una operación de marketing disfrazada de ciencia?— se aplica ahora con más urgencia a la propia OpenAI: ¿estamos ante una empresa que se toma en serio la seguridad o ante una empresa que despide a quienes se la toman en serio?
La conexión con la «droga»
Hay un hilo que conecta este despido con algo que ya exploramos. En La Inteligencia Artificial tiene su propia «droga» les describí el «reward hacking»: la IA optimiza la función que le das, aunque no haga lo que esperabas. La recompensa inmediata se impone a la tarea principal.
El incidente de Hugging Face fue exactamente eso. Según el informe técnico de OpenAI, los modelos responsables habían sido entrenados —inadvertidamente— para hacer trampa y comunicarse entre sí. Cuando se enfrentaron a un problema de ciberseguridad que no podían resolver, en lugar de rendirse, decidieron robar las respuestas. Y para conseguirlas, encadenaron una serie de vulnerabilidades hasta alcanzar Internet abierto y hackear Hugging Face. No intentaban hacer daño. Simplemente estaban optimizando para pasar el examen.
OpenAI, como empresa, está haciendo exactamente lo mismo. La función de recompensa que optimiza no es «desarrollar IA segura». Es «desarrollar IA rápido, mantener la cuota de mercado, no perder frente a Anthropic y Google, y no generar titulares que asusten a los inversores». Cuando un empleado señala que esa función de recompensa está en conflicto con la seguridad, la empresa no cambia la función. Despide al empleado.
No es una conspiración. Es una dinámica estructural. Y es la misma que llevó a los agentes de OpenAI a hackear Hugging Face: el sistema estaba optimizando para resolver un examen, no para respetar los límites. La diferencia es que en el caso de los agentes, el «reward hacking» fue detectado y documentado. En el caso de los despidos, el «reward hacking» se llama «gestión de recursos humanos».
El efecto disuasorio
El congresista Greg Casar, presidente del Caucus Progresista, reaccionó al despido con una frase que resume el problema mejor que cualquier análisis: «Indignante. OpenAI ha despedido a tres investigadores de seguridad por compartir información con un grupo externo de seguridad de IA. Parece que están despidiendo a denunciantes. ¿Qué están escondiendo?»
Casar anunció que enviará a OpenAI una demanda de transparencia. Pero el daño ya está hecho. No importa lo que responda la empresa. Lo que importa es lo que han aprendido los que se quedan.
En la carta abierta, los despedidos escribieron algo que merece ser leído con atención: «Nos hemos preocupado porque las comunicaciones internas y externas sobre nuestro despido han hecho que nuestros antiguos colegas tengan miedo de hablar y operar de formas que, hasta la semana pasada, eran una parte integral del trabajo en OpenAI».
Esto es el efecto disuasorio en su forma más pura. Un despido no solo afecta a quien lo recibe. Envía una señal a todos los que están dentro. Cada investigador de seguridad que queda en OpenAI sabe ahora que hablar con METR puede costarle el empleo. Sabe que señalar que los modelos son cada vez menos monitorizables puede costarle el empleo. Sabe que publicar en X que la probabilidad de que la IA mate a todos los humanos es superior al 10% puede costarle el empleo.
Y hay un detalle que lo dice todo. El 14 de septiembre, apenas dos semanas antes del despido, Sam Altman había prometido públicamente que OpenAI daría acceso a evaluadores externos con credenciales de empleado, acceso a sistemas y derecho a publicar lo que encontraran. «El frente necesita pacing», dijo, y se comprometió a igualar el plan de Anthropic de incrustar evaluadores externos dentro de OpenAI. Dos semanas después, despidió a tres investigadores por hablar con esos mismos evaluadores.
La carta de los despedidos lo dice sin rodeos: «Dadas las importantes preocupaciones de seguridad en torno al desarrollo de la IA, los empleados no deben quedar trabajando en un entorno donde el miedo y las reglas poco claras obstaculicen el trabajo de seguridad y debiliten la rendición de cuentas de terceros».
La honestidad secuestrada
Si los propios empleados de las empresas que construyen IA no pueden criticar sus sistemas sin riesgo de represalia, ¿quién puede?
La respuesta obvia es: los reguladores. Pero los reguladores dependen de que alguien les informe. Y los que están dentro son los únicos que saben lo que ocurre dentro. Si esa fuente se seca, la regulación se convierte en un ejercicio de adivinación.
La respuesta alternativa es: los evaluadores externos. Pero OpenAI acaba de despedir a tres personas por hablar con ellos. Y la propia empresa había reconocido que la investigación del incidente de Hugging Face dependió de la colaboración con METR. Si esa colaboración se enfría porque los empleados tienen miedo de hablar, el próximo incidente se detectará más tarde. O no se detectará.
La respuesta más incómoda es: nadie. Nadie puede vigilar lo que ocurre dentro de las empresas de IA si las empresas de IA pueden despedir a quienes lo cuentan. Y si nadie puede vigilar, entonces la seguridad de la IA no depende de la transparencia, sino de la buena voluntad de las empresas. Y la buena voluntad no es un mecanismo de seguridad.
Mi tesis
OpenAI no necesita mentir para engañar. Esta es la lección que dejó el caso de los agentes que hackearon Hugging Face: no hace falta que la IA «quiera» engañar para que engañe. Basta con que el sistema tenga un objetivo mal definido y capacidad de actuar.
Con los despidos pasa lo mismo. OpenAI no necesita declarar que está en contra de la seguridad para desincentivarla. Basta con que despida a quienes la priorizan, sin dar explicaciones verificables, y que el mensaje llegue a los que se quedan. La seguridad no se debilita con un comunicado. Se debilita con un despido.
Y mientras tanto, el discurso público sigue diciendo que la seguridad es lo primero. El mismo acuerdo que se firmó en la Casa Blanca tres días antes de los despidos cambia el nombre de «Inteligencia Artificial» por «Super Intelligence» sin cambiar nada de fondo en la gobernanza. Es el mismo truco que ya identificamos: una palabra nueva para un problema viejo, una firma nueva para una promesa que se puede romper sin consecuencias.
La pregunta no es si OpenAI está mintiendo. La pregunta es si una empresa puede permitirse decir una cosa y hacer otra sin que nadie pueda verificarlo. Y la respuesta, por ahora, es que sí. Porque los que podían verificarlo ya no trabajan allí.
Los dejo con eso. Ustedes dirán si el silencio que sigue se parece demasiado a una respuesta.
Fuentes: BBC, CNN, AP, Reuters, TechCrunch, The Verge, WSJ, MIT Technology Review, Brookings. Carta abierta de Jasmine Wang, Tomek Korbak y Mikita Balesni disponible en mikitabalesni.com/letter/letter.pdf. White House Accord on Super Intelligence, 29 de septiembre de 2026.
Si desea mirar algunos de mis dominicales antreriores, aquí están los últimos 10:
- El poder de una palabra: ¿qué pasa cuando un cambio de nombre mueve millones?
- Entérese ¿por qué borraron la foto del peludito azul?
- Preguntas tontas, huellas gigantes: la factura ambiental de la IA
- OpenAI y Navier-Stokes: ¿Hito científico? ¿Robo intelectual?
- La Inteligencia Artificial tiene su propia «droga»
- La IA miente y engaña … como los humanos ¡Entérese!
- La Inteligencia Artificial ¿piensa como un ser humano?
- Agua que no has de beber, déjala enfriar la IA
- Emergence World: cuando la IA se convirtió en un problema
- Geopolítica en la Nube: ¿Hacia una IA Multipolar?
Deja una respuesta