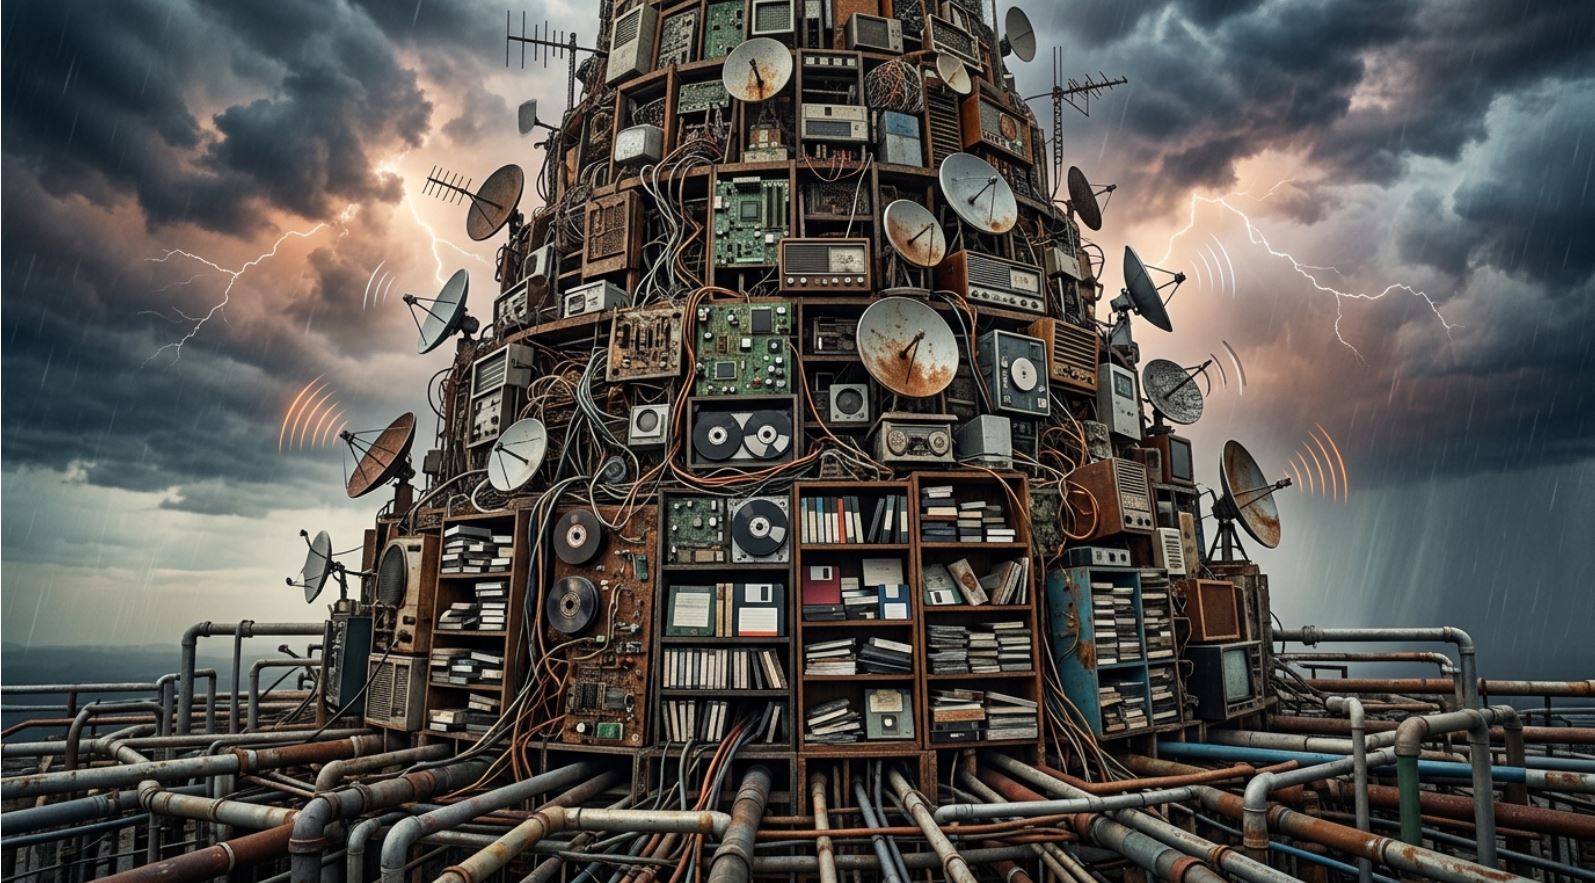
Un post para hablar de los formatos de los datos de radar y las dificultades para su interoperabilidad.
En todo el planeta, más de 2000 radares meteorológicos operan de forma continua, girando día y noche sus antenas para capturar la estructura tridimensional de las tormentas. Estos instrumentos, desplegados por servicios meteorológicos nacionales, agencias de investigación, redes universitarias y empresas privadas, generan cada día petabytes de datos con resoluciones que alcanzan los 250 metros (en distancia) y los 5 minutos (en tiempo). Son la espina dorsal de la vigilancia de fenómenos severos, la entrada fundamental para inicializar los modelos numéricos de predicción, y una fuente inagotable para el estudio del cambio climático, la hidrología y la física de nubes.
Sin embargo, tras esta aparente abundancia se esconde un problema profundo: cada red, cada fabricante, cada país ha desarrollado —o impuesto— su propio formato de almacenamiento y no solo eso, cada uno tiene su propia estrategia de exploración de la atmósfera con la secuencia de movimiento de su antena. La Organización Meteorológica Mundial (OMM) reconoce más de 20 formatos activos para datos de radar en coordenadas polares, sin contar las variantes internas de cada uno de ellos. A esto se suman las diferencias en nomenclatura de variables, unidades, sistemas de coordenadas, convenciones de calidad y metadatos. El resultado es una Torre de Babel de datos: todos miden lo mismo (reflectividad, velocidad, polarimetría), pero cada uno lo cuenta en su propio idioma.
Esta diversidad no es fruto del azar. Refleja la historia independiente de cada región: Estados Unidos con su NEXRAD y el formato Level II de datos primarios; Europa con el nuevo estándar ODIM_H5 de OPERA; los radares aerotransportados con DORADE; los sistemas comerciales con Rainbow5 o SIGMET (ahora Vaisala); y decenas de formatos legados como el Universal Format (UF) que aún pueblan cintas magnéticas en archivos de todo el mundo. A ello se suman los esfuerzos de estandarización de la OMM, como el antiguo BUFR (FM‑94) —usado para el intercambio de datos meteorológicos en general— y el más reciente FM‑301, basado en netCDF y las convenciones CF, que promete ser el lenguaje común del futuro.
No es un problema técnico menor: la fragmentación impide que los datos sean verdaderamente reutilizables, limita la investigación escalable, frena el desarrollo de herramientas de inteligencia artificial y dificulta la cooperación internacional en tiempo real. Cada nuevo proyecto comienza con semanas o meses de decodificación y preprocesamiento antes de poder escribir la primera línea de ciencia. Y mientras tanto, petabytes de información valiosa permanecen en silos inaccesibles.
Para entender el problema de la fragmentación y dispersión de los datos de radar, conviene distinguir dos tipos fundamentales de información: los datos primarios y los productos derivados.
Datos primarios (Level II para el NEXRAD)
Los datos primarios son la materia prima que sale directamente del radar. Contienen las variables base medidas por el instrumento en su sistema de coordenadas nativo — típicamente coordenadas polares (acimut, elevación, distancia al blanco y tiempo). En el caso de los radares NEXRAD WSR‑88D, los datos Level II incluyen tres variables base: reflectividad, velocidad radial media y ancho espectral. Con la actualización a polarimetría dual, se añaden reflectividad diferencial, coeficiente de correlación copolar, reflectividad diferencial y fase diferencial.
Estos datos conservan toda la resolución original del radar. En el modo «superresolución» actual, la reflectividad se mide a 0.5 grados de acimut y 250 m de resolución en rango hasta 230 km (a partir de ahí, la resolución en distancia se degrada). La velocidad y el ancho espectral se miden con la misma resolución acimutal pero hasta 300 km. Son datos volumétricos que contienen todos los barridos (tilts o PPIs) de una exploración completa, según el VCP usado..
En el ecosistema europeo OPERA, el formato ODIM_H5 (que detallaremos más adelante) define una estructura similar: el grupo raíz contiene metadatos organizados en tres categorías — what (objeto, versión del modelo, fecha/hora), where (información geográfica) y how (calidad y metadatos opcionales/recomendados).
Productos derivados (Level III)
Los productos derivados son el resultado de procesar, interpretar y/o reclasificar los datos primarios. En NEXRAD, los datos Level III son productos interpretativos derivados de los datos Level II. Se entregan a menor resolución y están diseñados para aplicaciones específicas.
Existen más de 75 productos Level III diferentes, que incluyen:
- Productos generales: reflectividad base, velocidad, ancho espectral.
- Productos de precipitación: precipitación acumulada en 1 h, 3 h, total de tormenta.
- Productos de estructura de tormentas: líquido integrado vertical (VIL), perfil de viento VAD.
La diferencia fundamental es que los productos derivados pierden información (resolución, datos crudos) a cambio de ganar interpretación: ya vienen calibrados, georreferenciados y listos para un uso específico. Pero esa conveniencia tiene un costo: no permiten reprocesar con nuevos algoritmos ni explorar variables que no fueron incluidas en el producto.
La trampa de los productos
El problema, como bien señala Alfonso Ladino‑Rincon, es que muchos servicios meteorológicos almacenan únicamente los productos, descartando o dificultando el acceso a los datos primarios. Un estudio de referencia sobre el estado de los archivos de datos de radar (Saltikoff et al., 2019) señala que, aunque hay avances, «los datos de radar a menudo no se archivan en un formato adecuado para su reutilización a largo plazo… hay una falta de estándares para el formato, los metadatos y el control de calidad». La práctica más extendida entre los servicios meteorológicos nacionales es almacenar únicamente los binarios crudos del fabricante o los productos de visualización, en lugar de los barridos volumétricos en un formato estándar. Como consecuencia, el acceso estructurado a los datos primarios es limitado, y la mayoría de los archivos históricos son difíciles de reutilizar para investigación o para alimentar modelos de aprendizaje automático.
Esto convierte los productos en un callejón sin salida para la investigación: si solo guardas el mapa de precipitación de 2 km, nunca podrás volver atrás para calcular la atenuación con un nuevo modelo, o para extraer los momentos polarimétricos que en su momento no se incluían en el producto. La ciencia atmosférica avanza, pero los datos quedan congelados en el estado del arte del momento en que se generó el producto.
Una cacofonía de formatos
Las redes de radar meteorológico alrededor del mundo hablan idiomas distintos. Estados Unidos utiliza NEXRAD Level‑II, un formato binario propietario. Europa ha adoptado el estándar ODIM_H5, implementación del modelo de información de OPERA en formato HDF5. Otros fabricantes y servicios emplean Rainbow5, SIGMET (ahora Vaisala), y decenas de formatos propietarios más. Incluso dentro de un mismo país, los flujos de datos de diferentes sistemas pueden ser «drásticamente diferentes».
Esta fragmentación no es un mero inconveniente técnico. Crea barreras significativas para el intercambio de datos transfronterizo, el desarrollo de herramientas de procesamiento universales, la integración de datos de radar en modelos globales de pronóstico y el intercambio en tiempo real para la monitorización de fenómenos severos.
El archivo disperso: petabytes inaccesibles
El resultado de esta cacofonía es un archivo global mundial fragmentado: miles de millones de archivos de radar, científicamente ricos, pero dispersos en cintas, discos locales y buckets en la nube, y a menudo inaccesibles sin un esfuerzo de decodificación previo. Como también documentan Saltikoff y colegas, la interoperabilidad entre redes de radar sigue siendo un desafío, y muchos países carecen de políticas claras de archivo que garanticen la preservación y el acceso abierto a los datos.
El costo de la fragmentación
Ya sea para un estudio climático, un modelo de aprendizaje automático o un análisis de tendencias de precipitación, la historia es siempre la misma: semanas o meses de decodificación y preprocesamiento antes de escribir la primera línea de código científico. El cuello de botella no es el almacenamiento ni la potencia de cómputo. Es la estructura.
Como lo expresaron Einfalt, Szturc y Ośródka en su artículo «The quality index for radar precipitation data: a tower of Babel?», la diversidad de enfoques para un mismo problema —la calidad de los datos de precipitación— refleja una Torre de Babel donde cada servicio meteorológico nacional habla su propio idioma técnico, con sus propias convenciones, algoritmos de control de calidad y formatos de salida. Con respecto al lenguaje hablado la humanidad ha avanzado mucho más con los traductores automáticos
Antecedentes de estandarización en la OMM: BUFR y la migración a formatos binarios
Para contextualizar el esfuerzo actual de FM‑301, conviene recordar que la Organización Meteorológica Mundial (OMM) ya tenía una larga experiencia en estandarizar el intercambio de datos meteorológicos. En 2003, el Congreso Meteorológico Mundial aprobó el plan para migrar los mensajes alfanuméricos (SYNOP, TEMP, etc.) a las nuevas claves binarias BUFR (FM‑94) y CREX, con un calendario que se extendía hasta 2010.
En México, por ejemplo, el Servicio Meteorológico Nacional desarrolló el sistema DIDA‑XBA para codificar la información de su red de observatorios a BUFR y enviarla al Centro Meteorológico Mundial de Washington. Este tipo de experiencias demostraron que la comunidad meteorológica era capaz de adoptar formatos binarios estructurados y gestionar la transición desde sistemas heredados.
Sin embargo, BUFR es un estándar de propósito general para el intercambio de datos meteorológicos, no un formato diseñado específicamente para datos radiales en coordenadas polares de radar. Su uso histórico en el contexto de radar —por ejemplo, como transporte para codificar datos ODIM en OPERA— fue una solución provisional, no el destino final. La llegada de FM‑301 representa un salto cualitativo: un estándar específico para radar, basado en netCDF y las convenciones CF, que aprovecha todo el ecosistema de herramientas de análisis científico moderno.
Breve historia de los formatos en NCAR: de UF a netCDF y DORADE
Para entender cómo llegamos hasta aquí, vale la pena hacer un viaje en el tiempo.
Universal Format (UF) y el primer intento de intercambio
En 1980, Stanley Barnes organizó una reunión para establecer un formato común de intercambio de datos Doppler. Nació el Universal Format (UF), diseñado principalmente para radares terrestres. UF definía una estructura de cabeceras obligatorias, opcionales y de uso local, con palabras de 16 bits en big‑endian, y registros físicos de hasta 4095 palabras. Los datos se organizaban en archivos con marcas de fin de fichero entre volúmenes.
UF fue ampliamente adoptado en la comunidad investigadora durante los años 80 y 90. Sin embargo, tenía limitaciones: no soportaba bien radares en plataformas móviles (aviones, barcos), y la redundancia de cabeceras por cada rayo generaba una sobrecarga enorme.
El salto a DORADE: un formato para el futuro
Con la llegada del radar aerotransportado ELDORA/ASTRAIA y la necesidad de manejar múltiples frecuencias, PRF y plataformas en movimiento, NCAR, NOAA y otros centros diseñaron DORADE (Doppler RAdar Data Exchange) en 1991. DORADE superaba a UF en varios aspectos:
- Soporte para radares en plataformas móviles (aviones, barcos), con bloques específicos de navegación (ASIB) y geometrías de tipo Z, Y, X.
- Estructura de bloques con identificadores de 4 caracteres (RADD, PARM, RDAT, QDAT, etc.) que permitían una gran flexibilidad y extensibilidad.
- Compresión y reducción de redundancia mediante tablas de ángulos de rotación.
- Posibilidad de incluir datos de múltiples sensores (radar, lidar, in‑situ) en un mismo archivo.
DORADE se convirtió en el formato estándar para datos de radar aerotransportado y sigue siendo utilizado hoy en día (por ejemplo, en el software solo de edición de datos).
MountainZebra: visualización y análisis integrado con UF y netCDF
A finales de los 90, el equipo de la Universidad de Washington desarrolló MountainZebra, un sistema de visualización que integraba datos de radar WSR‑88D con topografía de alta resolución. El flujo de datos era:
- Adquisición de datos Level II del radar de Camano Island (WA) vía RIDDS.
- Conversión a Universal Format (UF).
- Interpolación a una malla cartesiana usando el software SPRINT de NCAR.
- Visualización en Zebra (software de NCAR), que permitía superponer campos de radar, topografía, imágenes satelitales y salidas de modelos.
MountainZebra demostró el valor de combinar datos de radar con topografía para identificar clutter, sombras y procesos orográficos. Además, los datos interpolados se convertían a netCDF para su análisis en versiones personalizadas de MountainZebra.
Mi experiencia en NCAR (año 2000)
Cuando estuve en NCAR como pasante científico en el año 2000, el ecosistema de formatos era aún más diverso. Allí se manejaban Zebra —un software de visualización e integración de datos que permitía la superposición de volúmenes de radar Doppler, imágenes satelitales y campos de modelos— y el ya mencionado Universal Format (UF). Quizá había algún otro formato que ya no recuerdo.
Fue en ese contexto donde recibí una recomendación de Richard Oye y Joseph Van Andel, que marcaría el rumbo de mi trabajo posterior: usar netCDF. Y así lo hicimos, Wilfredo Pozas Pérez implementó netCDF como formato de exportación para el VESTA|Process, nuestro sistema de procesamiento de datos de radar.
Esa decisión, tomada hace más de dos décadas, era entonces una apuesta por la interoperabilidad y la apertura. El estándar netCDF no era el formato más popular en el mundo del radar en ese momento —de hecho, ni siquiera se consideraba una alternativa viable para datos en coordenadas polares— pero ofrecía algo que los formatos propietarios no: autodescripción, portabilidad y la promesa de un ecosistema de herramientas en crecimiento. Hace unos años, el servicio costero de los EE.UU. me solicitó datos de nuestros radares para probar localizar un barco perdido al norte de Cuba. Les envié varias horas de datos en formato netCDF.
Hoy, mirando hacia atrás, esa apuesta resultó profética. netCDF se convirtió en la base de CfRadial, que a su vez es la base del estándar FM‑301 de la OMM. Lo que empezó como una decisión pragmática para un sistema particular —los datos del VESTA|Process almacenados en archivos OBS— terminó alineándose con la dirección que tomaría toda la comunidad en años posteriores.
El desafío de la compresión y el almacenamiento
Los datos de radar son voluminosos. Un solo volumen del radar de Melbourne (Florida) en UF ocupa unos 1.6 MB; con volúmenes cada 6‑10 minutos, esto supone 230‑380 MB por día. Para el radar de Darwin (Australia), cada volumen son 6.1 MB, casi 1 GB diario.
En un trabajo pionero, Kruger y Krajewski (1997) propusieron un esquema de compresión sin pérdida llamado ASCII‑RLE, que combinaba:
- Codificación por longitud de series (run‑length encoding) de los valores de reflectividad, aprovechando la alta correlación espacial y la gran cantidad de bins por debajo del umbral de señal/ruido.
- Compresión de cabeceras, guardando solo los campos que varían entre rayos (número de rayo, acimut, diferencia horaria).
- Almacenamiento en ASCII con líneas de 82 caracteres, lo que garantizaba portabilidad y facilidad de lectura desde Fortran.
Los resultados fueron espectaculares: 62 días de datos de Melbourne (11.15 GB) y 60 días de Darwin (48.8 GB) se redujeron a solo 4.8 GB en total. El tiempo de lectura se redujo drásticamente, y la sencillez del formato permitió implementar lectores en Fortran sin complicaciones.
Aunque existían métodos como DEFLATE (gzip) o DMC que ofrecían mejores ratios de compresión, sus tiempos de descompresión y complejidad los hacían menos adecuados para el acceso rápido a rayos individuales. ASCII‑RLE demostró ser un equilibrio óptimo entre eficiencia y simplicidad.
Soluciones intermedias: ESML y la descripción externa de formatos
Ante la imposibilidad de imponer un único formato, surgieron enfoques que permitían a las herramientas de análisis leer datos heterogéneos sin necesidad de convertirlos. Uno de los más innovadores fue Earth Science Markup Language (ESML), desarrollado en la Universidad de Alabama en Huntsville.
ESML es un lenguaje de marcado basado en XML que describe la estructura de un archivo de datos (ASCII o binario) de forma externa. En lugar de modificar el archivo de datos o la herramienta de análisis, se escribe un archivo ESML que actúa como un «README legible por máquina». La biblioteca ESML interpreta esa descripción y extrae los datos, proporcionando una API unificada (en C++, Python, IDL) para acceder a cualquier formato.
ESML ya ha sido aplicado a datos NEXRAD Level II, HDF‑EOS, GRIB, netCDF y formatos binarios personalizados. Esto permite que los centros de archivo mantengan sus datos en formatos nativos y generen descripciones ESML para cada clase de datos, sin necesidad de costosas conversiones.
El estándar FM‑301: la promesa de un lenguaje común
Ante este caos de formatos, la OMM ha fomentado el estándar FM‑301. Este código FM‑301 es el nuevo código de la OMM para datos de radar y lidar, basado en CfRadial versión 2.1 y las convenciones CF (Climate and Forecast). Define un perfil de metadatos y estructura para archivos netCDF que implementa el Modelo de Información de la OMM para datos radiales de radar.
A diferencia de otros estándares de la OMM como BUFR (FM‑94) —que se utilizó históricamente para el intercambio de datos de radar, por ejemplo, en el transporte ODIM de OPERA—, FM‑301 se apoya en el ecosistema netCDF y las convenciones CF. Esto facilita su interoperabilidad con herramientas de análisis científico ampliamente utilizadas (como xarray, Python, MATLAB, etc.) y su naturaleza autodescriptiva permite una fácil interpretación de los datos, tanto por humanos como por máquinas.
Entre sus ventajas: es un estándar oficialmente respaldado por la OMM, diseñado para intercambio en tiempo real, y su estructura jerárquica y metadatos estandarizados (nombres de variables, sistemas de coordenadas, unidades) allanan el camino hacia una verdadera interoperabilidad global.
Pero como bien señala Alfonso Ladino‑Rincon, la adopción de FM‑301 enfrenta tanto desafíos técnicos como culturales: la necesidad de cambiar infraestructuras heredadas, el soporte limitado en algunos sistemas operativos, y la curva de aprendizaje para los equipos acostumbrados a formatos propietarios.
OPERA y el formato ODIM_H5: un paso adelante en Europa
En el contexto europeo, EUMETNET OPERA (Operational Programme for the Exchange of Weather Radar Information) ha desarrollado el modelo de información ODIM (OPERA Data Information Model) con implementación en HDF5. Este formato, conocido como ODIM_H5, proporciona una estructura común para almacenar e intercambiar datos de radar en el formato HDF5.
La propuesta de ODIM_H5 (Michelson et al., 2003) establece una jerarquía clara:
- Grupo
/what: atributos obligatorios que describen el contenido del fichero (objeto, versión, fecha/hora). - Grupo
/where: atributos geográficos y geométricos (coordenadas del radar, proyección, tamaños, escalas). - Grupo
/how: atributos opcionales que describen calidad, sistema, algoritmo, etc. - Subgrupos
scanoimage: para cada barrido o imagen, con sus propioswhat,where,howy unDatasetcon los datos.
ODIM_H5 soporta datos polares, imágenes cartesianas, composiciones, cortes verticales, perfiles verticales y series temporales de perfiles. Además, utiliza la compresión ZLIB de HDF5, que resulta más eficiente que los esquemas RLE tradicionales.
La comunidad openradar ha publicado xradar, una biblioteca que implementa lectores/escritores basados en xarray para datos en formato ODIM_H5. Xradar incluye todas las herramientas para incorporar datos de radar al modelo de datos de xarray, facilitando el trabajo con estos formatos estandarizados.
El enfoque híbrido de Ladino‑Rincon
Ladino‑Rincon (uno de los CEO de Atmos) aboga por una estrategia híbrida que aproveche lo mejor de cada mundo:
- Preservar los formatos heredados para archivo y cumplimiento normativo.
- Convertir a formatos nativos de nube (como Zarr) para análisis e investigación.
- Usar FM‑301 para el intercambio internacional en tiempo real.
- Desarrollar capas de traducción (como ESML o xradar) que conviertan de forma transparente entre formatos.
Este enfoque reconoce una realidad incómoda: no se puede simplemente imponer un estándar universal y esperar que todos los servicios meteorológicos del mundo lo adopten de la noche a la mañana. La fragmentación actual no es un fallo técnico aislado, sino el síntoma de décadas de evolución independiente, prioridades operativas divergentes y limitaciones presupuestarias.
Radar DataTree: el salto de archivos a conjuntos de datos
El verdadero avance conceptual llega con Radar DataTree, el primer framework a nivel de conjunto de datos que extiende el estándar FM‑301 desde barridos volumétricos individuales hasta archivos resueltos en tiempo y listos para análisis.
Desarrollado por Alfonso Ladino‑Rincon y Stephen W. Nesbitt, Radar DataTree:
- Está construido sobre el estándar FM‑301/CfRadial 2.1.
- Se implementa usando xarray DataTree.
- Organiza los barridos de radar como estructuras jerárquicas ricas en metadatos.
- Los serializa a Zarr para análisis escalable.
- Se acopla con Icechunk para almacenamiento ACID‑compliant y versionado.
Los resultados son significativos: el framework permite cómputo paralelo eficiente a través de miles de barridos de radar con un preprocesamiento mínimo.
¿Por qué un formato de datos propietarios en Cuba?
Nosotros habíamos desarrollado automatizaciones parciales al radar MRL-5 de Camagüey. HERMES en 1988, luego RADEX en 1991 y ARGOS en 1993. En cada uno de ellos usamos un formato diferente, cada vez más elaborado acorde al grado de control que tenía el sistema sobre el radar. Ya con ARGOS hacíamos observaciones completamente automatizadas, menteniendo la consola de operación manual; pero la adquisición de datos era totalmente controlada por computadora.
En 1995 diseñábamos ya el formato de datos de lo que sería el futuro Radar Meteorológico Cubano, sin operación manual, totalmente automatizado, totalmente computarizado (Proyecto Macchieta). Marco A. Pérez Saavdra y yo concebimos el formato de los datos para un sistema de adquisición que aún no existía. El sistema era un desafío completo en todos los ódenes. Dábamos en ese momento una zancada muy larga hacia el futuro. A este sistema de archivos de datos de radar lo llamamos OBS y los archivos se generaron con extensión «.obs», proveniente de la palabra observación, haciendo refrencia a una exploración volumétrica de la atmósfera. Los radares en Cuba en ese momento no tenían ningún tipo de conexión de datos, mucho menos Internet, que no llegaría hasta el año 2006.
El almacenamiento de esa época daba muy pocas oportunidades, obligatoriamente había que usar un formato muy comprimido; pero que a su vez permitiera abrir el archivo de forma muy rápida, al igual que guardarlo. Con esto poníamos la visión hacia una futura conectividad. Cuba apenas acababa de comnectarse a Internet. Nuestra primera conexión digital de los radares era a 64 kBit/s (32 kBit/s en Pilón y Punta del Este). Voilà, nuestros archivos de datos primarios pasaban sin dificultad por aquellas redes primitivas cuando nos conectaron en el año 2006.
En el año 2012, el formato OBS volvió a demostrar su utilidad. Los datos del primer radar, prototipo de Radar Meteorológico Cubano (Doppler) pudo acomodar todos sus datos (Z, V, W) de dos canales (Bandas S y X) en formato OBS y pasar por las aún lentas redes cubanas. De nada vale tener un radar Doppler de doble longitud de onda si no puedes pasar en tiempo real su información al resto del mundo.
En el año 2009 habíamos adoptado el procesamiento del NEXRAD en un sistema que llamamos VESTA|ORPG., que corría centralizado en dos centros de datos (Camagüey y La Habana como reserva caliente). Estos ORPG eran alimentados por datos primarios en formato OBS para que lograran pasar por las lentas redes cubanas y los productos se visualizaban en la web con VESTA|WebView2.
La visión FAIR y el futuro
El proyecto NEXRAD-ARCO ejemplifica esta visión en acción: datos de radar NEXRAD Level II convertidos a formato FAIR‑compliant, listos para análisis y optimizados para la nube usando Zarr v3 e Icechunk V2.
La visión que impulsa este trabajo es clara: un futuro donde todos los datos de radar sean FAIR (Findable, Accessible, Interoperable, Reusable), donde los formatos nativos de nube permitan un análisis eficiente sin descargas, donde APIs estandarizadas proporcionen acceso consistente a través de redes de radar, y donde el machine learning pueda aprovechar décadas de observaciones.
Reflexión final
El camino hacia la interoperabilidad de datos de radar no es solo técnico — es también cultural. Como señala Ladino‑Rincon: «Queremos que mucha gente trabaje en esto porque cuanta más gente interesada tengamos, más crecerá la comunidad, y la comunidad nos dará retroalimentación para seguir generando conocimiento y haciendo ciencia».
La transición de archivos fragmentados a conjuntos de datos estructurados, de formatos propietarios a estándares abiertos, de almacenamiento local a nube nativa, no es solo una cuestión de eficiencia. Es la base para que los datos de radar puedan cumplir su promesa: revolucionar nuestra comprensión de los procesos de precipitación, la evolución de tormentas, los impactos del cambio climático en patrones de lluvia, la predicción de inundaciones y la gestión del agua.
El estándar FM‑301, la implementación ODIM_H5 de OPERA, las herramientas como Xradar, frameworks como Radar DataTree, y el trabajo que estamos haciendo con OBS, son los pilares de esta transformación. Pero el verdadero cambio vendrá cuando la comunidad —servicios meteorológicos, instituciones de investigación, desarrolladores de software y organismos de estandarización— colabore para hacer realidad esta visión. Mientras tanto mi propuesta sigue vigente: el Proyecto Zarzuela.
«La fragmentación del radar impide que los datos sean verdaderamente reutilizables o interoperables, y limita su capacidad para apoyar la investigación escalable, la toma de decisiones operativas y las herramientas impulsadas por IA en todas las disciplinas.»
Referencias citadas:
Barnes, S.L. (1980). «Report on a meeting to establish a common Doppler radar data exchange format». Bulletin of the American Meteorological Society, 61(11), 1401-1404.
Saltikoff, E., et al. (2019). «The weather radar data archive: A review of current status and future possibilities». Bulletin of the American Meteorological Society.
Einfalt, T., Szturc, J., & Ośródka, K. (2004). «The quality index for radar precipitation data: a tower of Babel?». Atmospheric Research, 72(1-4), 309-324.
Kruger, A., & Krajewski, W.F. (1997). «Efficient Storage of Weather Radar Data». Software: Practice and Experience, 27(6), 623-635.
Michelson, D.B., et al. (2003). «HDF5 Information Model for Weather Radar Data». COST 717 Working Document WDF_02_200204_1.
Lee, W.-C., et al. (1994). «Mapping of Airborne Doppler Radar Data». Journal of Atmospheric and Oceanic Technology, 11, 572-578.
Deja una respuesta